Ubuntu 安装 scrapy 及 pip upgrade 时的各种依赖问题
安装 Scrapy 时遇到了依赖问题,使用 pip 时又发现自带的基础 py 包同样依赖不全,后一并 Google 解决,记一笔备忘。
首先安装 PIP,即 python 的包管理器。
1 | sudo apt-get install python-pip |
由于 ubuntu 官方库提供的 pip 不是最新的,因此需要先 upgrade 自己:
1 | sudo pip install --upgrade pip |
此时如果你直接试图安装 scrapy 是会出错的:
1 | sudo pip install scrapy |
原因是 scrapy 需要抓取网页因而要处理 https,而处理 https 又依赖加解密算法(即 cryptography 包),而 cryptography 又依赖傅立叶变换的算法以及相应的编译环境。Ubuntu 16.04 默认没有安装 libffi-dev 和 libssl-dev,gcc 也不一定安装,而 scrapy 包又没有将相关软件包记到依赖列表里,因此需要先手动安装:
1 | sudo apt-get install libssl-dev libffi-dev python-dev build-essential libxml2-dev libxslt1-dev |
然后再安装 scrapy 即可顺利完成。
顺便,由于更新强迫症,一并把 pip 自带的包均更新了一遍。pip 没有 apt 那么好用的 dist-upgrade 命令,需要先手动列出旧包然后逐项更新:
1 | > pip list --outdated |
这些 Py 包可以直接升级:
1 | sudo pip install --upgrade blinker |
这些 Py 包需要先安装 libssl-dev、libffi-dev、python-dev 以及 build-essential 以后才能升级(其实都是因为要依赖 cryptography):
1 | sudo apt-get install libssl-dev libffi-dev python-dev build-essential |
这些 Py 包需要先安装 python-dev 以及 libjpeg8-dev 以后才能升级:
1 | sudo apt-get install python-dev libjpeg8-dev |
解决。
话说 numpy 的编译时间真是长啊……


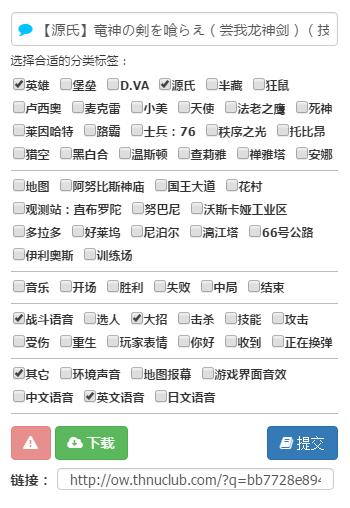 编辑语音标签
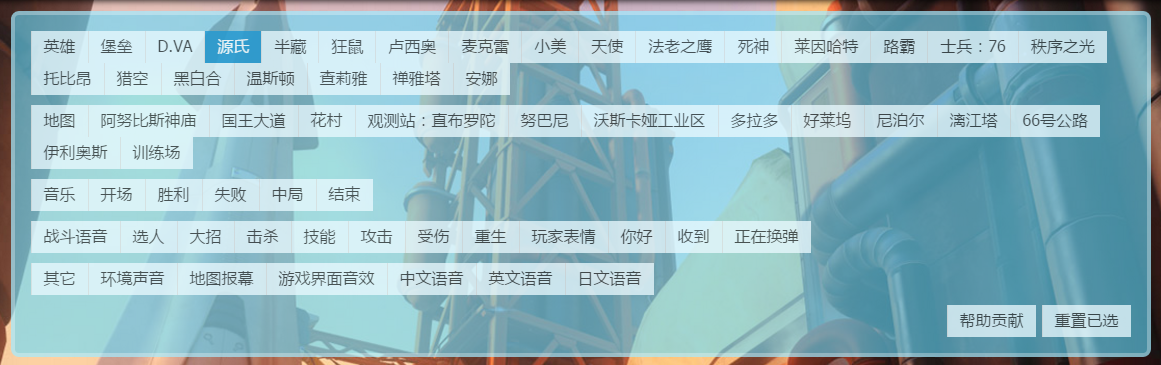 根据标签筛选
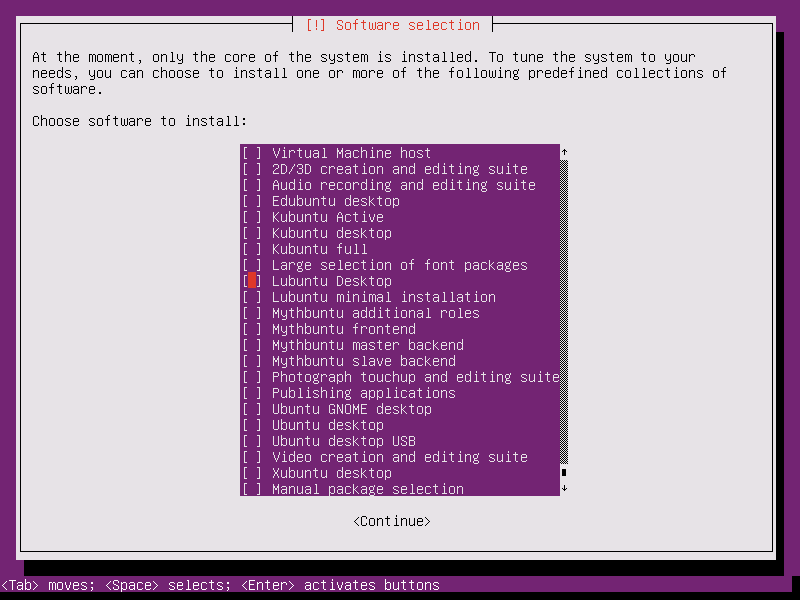 其实就是 Tasksel 整合安装器
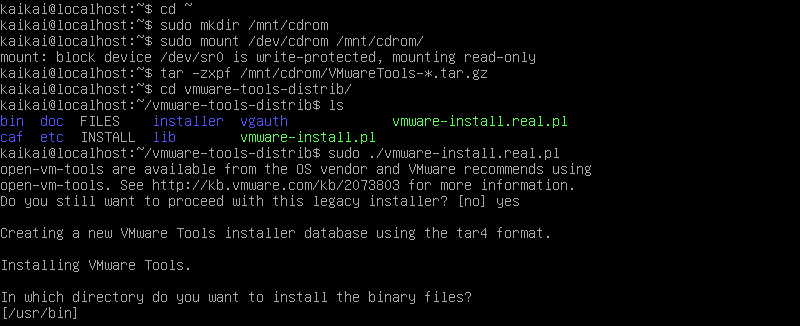
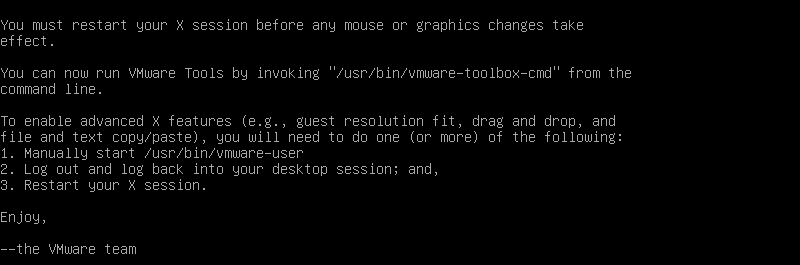
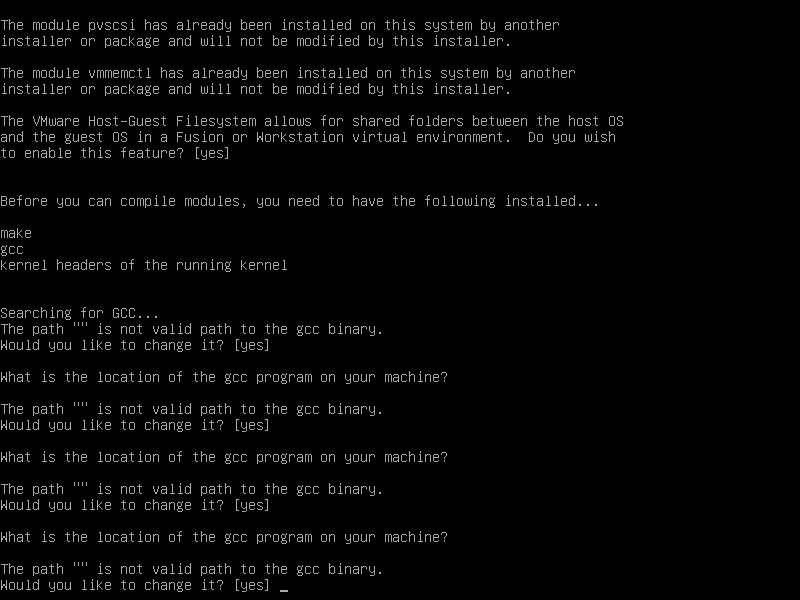 gcc 路径为空,无限循环无法往下

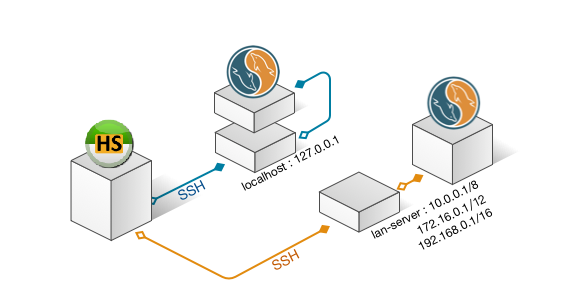
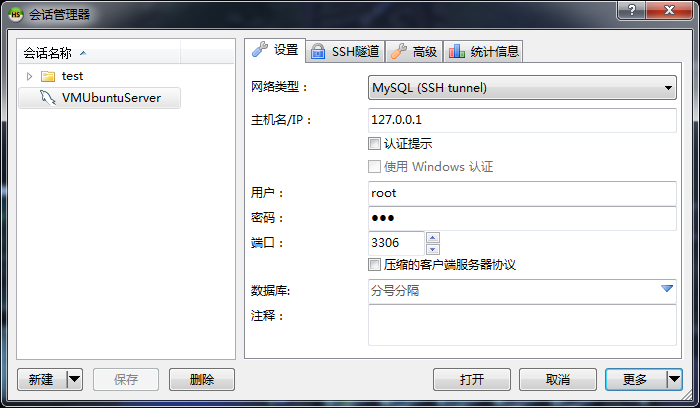 SSH 主机(不是本机)如何连接到数据库,很多中小网站的数据库只允许本地访问,则这里应当填写 127.0.0.1
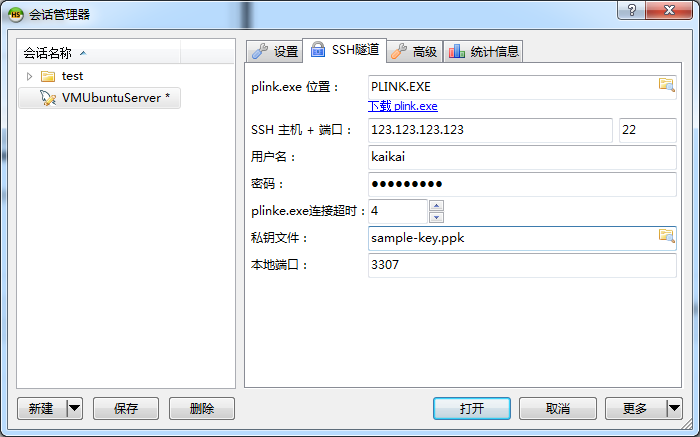 本机如何连接到 SSH 主机